Sistemas en los que puede confiar cuando hay mucho en juego
Diseñamos y desarrollamos soluciones fiables para la industria, las infraestructuras y el sector PropTech. Primero comprobamos si el problema tiene solución y después desarrollamos el sistema en un entorno real.
Compruebe el rumbo antes de invertir en el desarrollo
En los proyectos técnicos complejos, una decisión de inversión exige comprobar si la solución es viable.
Nuestra ventaja es que nos incorporamos al proceso de diseño y planteamos las preguntas clave. ¿Cuál es la principal necesidad de negocio? ¿Se puede hacer realmente? Empezamos por comprobar la viabilidad de la tarea con datos reales.
Solo cuando se confirma la hipótesis construimos el sistema. El prototipo que desarrollamos está listo para la integración, el escalado y el mantenimiento posterior. La fiabilidad que usted necesita nace de nuestra forma de trabajar en el producto.
Empezamos con una prueba de viabilidad y después escalamos el sistema
Discovery y análisis de riesgos
Reducimos el problema a preguntas de viabilidad. Estudiamos cómo trabajan las personas y su carga operativa en el entorno de destino.
Prototipos y PoC
Construimos la prueba de viabilidad con una muestra de sus propios datos. Usted comprueba el rumbo antes de un gran desarrollo.
Aplicaciones web e IoT
Conectamos software, sensores y datos operativos, teniendo en cuenta los límites de los dispositivos periféricos (edge).
IA y automatización
Utilizamos la IA para reducir el trabajo repetitivo. Cuando importa una precisión del cien por cien, diseñamos un proceso determinista.
Integración de sistemas
Conectamos su ERP y sus equipos de medición con el nuevo sistema sin costosas paradas operativas.
Ciberseguridad
Incorporamos el modelo de amenazas a la arquitectura. La clave privada permanece protegida en el propio dispositivo.
Cloud
Vendemos y configuramos infraestructura que cumple los requisitos legales. Como revendedores de AWS y Scaleway, optimizamos los costes y adaptamos el código al proveedor que usted elija.
Mantenimiento y evolución
Tras el lanzamiento, asumimos la responsabilidad de la monitorización, las actualizaciones y la evolución del sistema con un SLA estricto.
Reducimos el riesgo antes de construir el sistema
Empezamos por establecer qué puede decidir el éxito del proyecto. Queremos asegurarnos de que la decisión de inversión se apoya en evidencias que usted mismo puede verificar. Trabajamos en tres pasos.
Definición de riesgos y preguntas
Identificamos los riesgos clave y las preguntas a las que debe responder el proyecto.
PoC con datos reales
Construimos una Proof of Concept o un prototipo que pone a prueba rápidamente los supuestos en condiciones cercanas a las del entorno de destino.
Sistema de producción listo para escalar
Si la solución funciona, usted ya cuenta con una base sólida. A partir de ahí, desarrollamos el sistema existente para que esté listo para la integración, el escalado y el mantenimiento.
Problemas difíciles que hemos resuelto
Antes de empezar a construir, teníamos que confirmar que el rumbo elegido tenía posibilidades de funcionar. Conozca nuestros proyectos y vea cómo resolvimos las incógnitas clave.
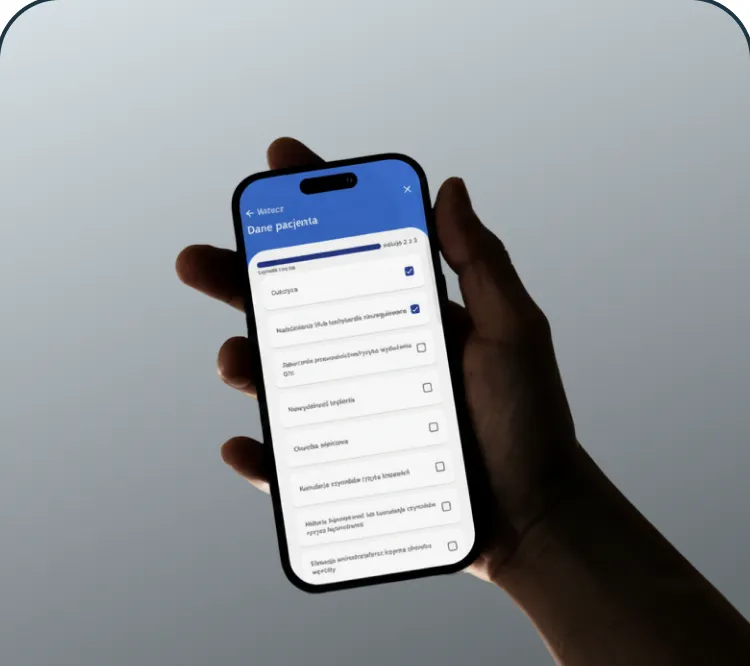 App educativa sobre salud mental: Diagnozuj i LeczJunto con Angelini Pharma, creamos la app «Diagnozuj i Lecz» (Diagnosticar y tratar). Ayuda a los médicos y a las personas que reconocen los primeros síntomas de la depresión. El objetivo principal del proyecto es sensibilizar sobre la salud mental.
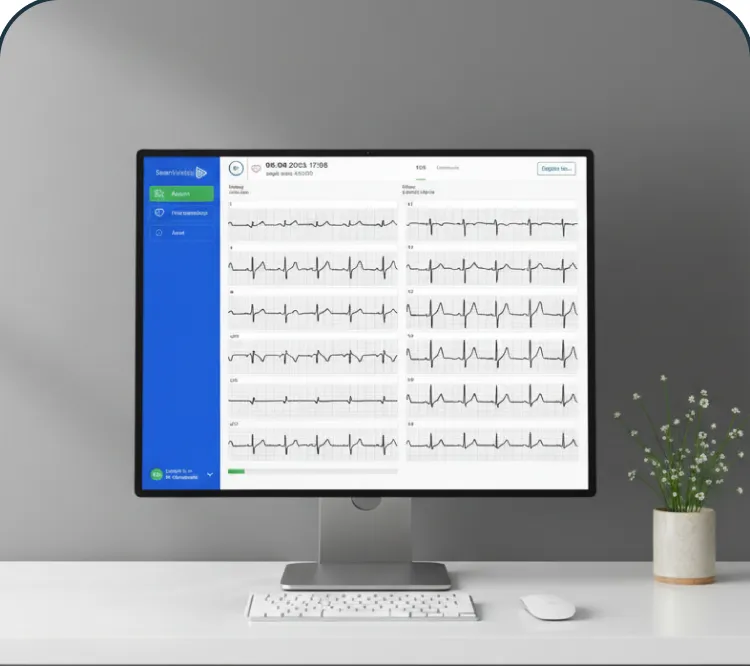 App móvil de ECG para SmartMedicsSmartMedics es una app que se conecta con equipos de ECG. Ayuda a los médicos a diagnosticar y monitorizar a los pacientes en tiempo real.
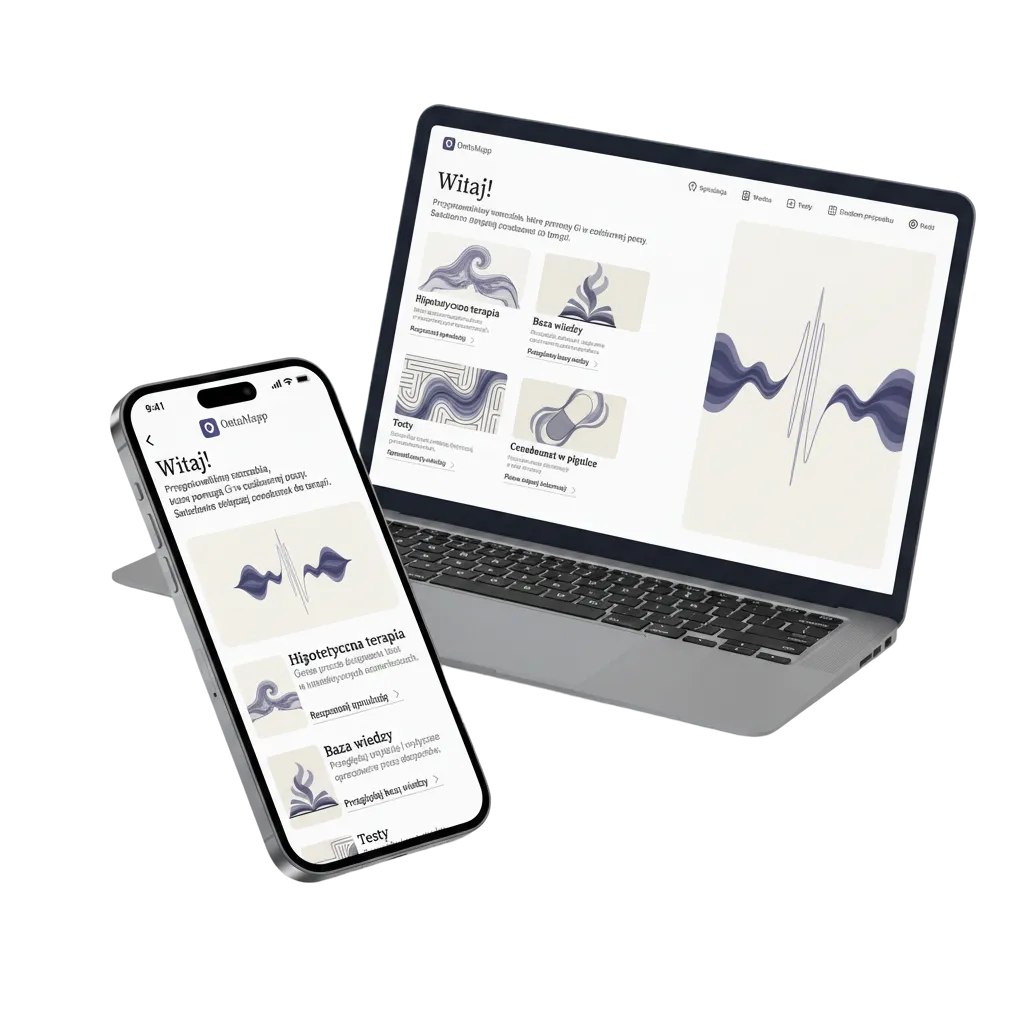 Plataforma educativa para neurólogos sobre la epilepsia farmacorresistenteDiseñamos una plataforma que ayuda a los neurólogos a tomar decisiones sobre el tratamiento antiepiléptico. El proyecto tenía que reunir en una sola herramienta el conocimiento médico, la experiencia de usuario y los requisitos de negocio.
- App educativa sobre salud mental: Diagnozuj i LeczJunto con Angelini Pharma, creamos la app «Diagnozuj i Lecz» (Diagnosticar y tratar). Ayuda a los médicos y a las personas que reconocen los primeros síntomas de la depresión. El objetivo principal del proyecto es sensibilizar sobre la salud mental.
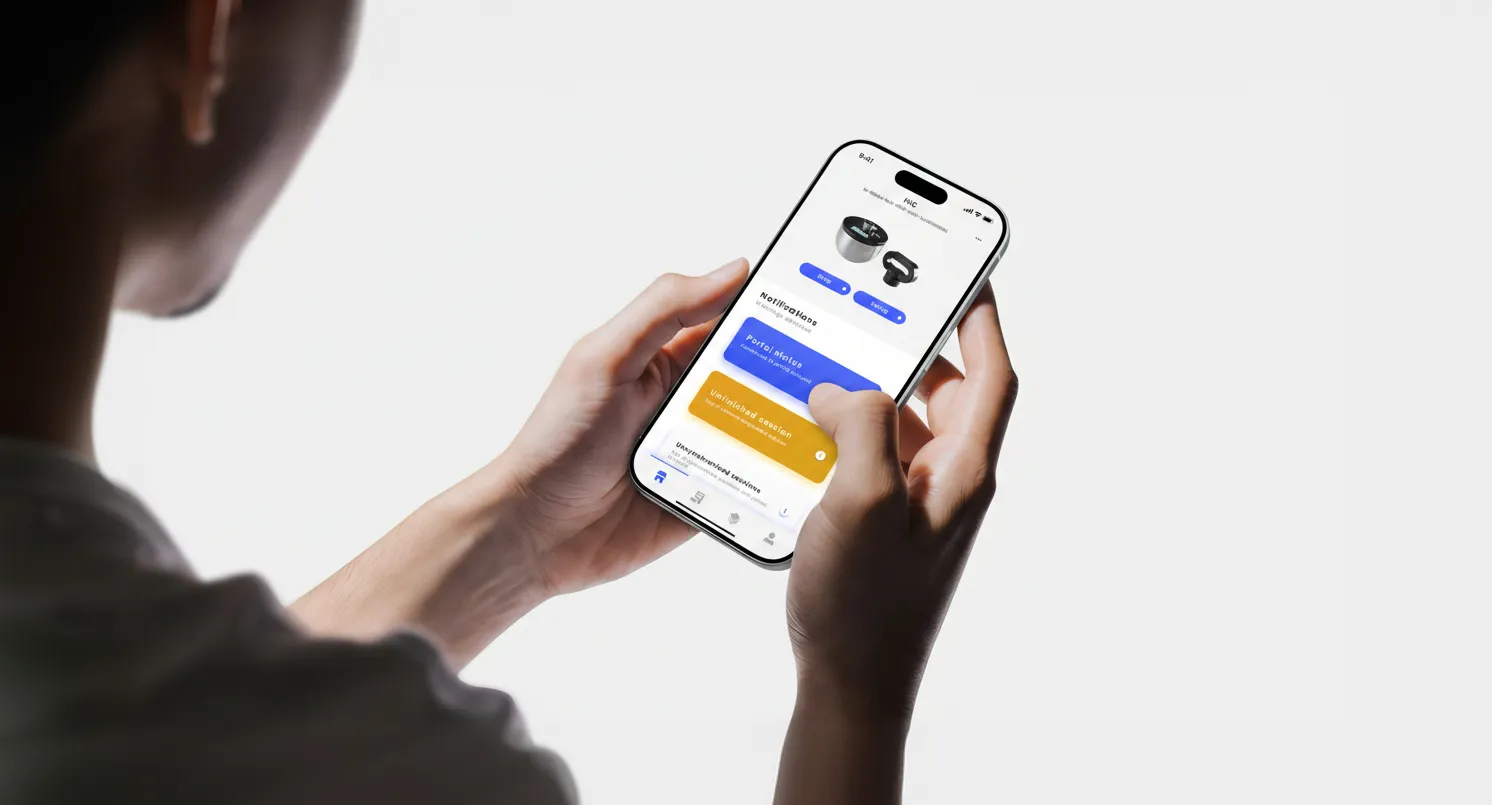 Construimos el producto y seguimos desarrollando la appPlaygrounds & Pitches es una plataforma móvil y web para evaluar la seguridad de las superficies deportivas. La app funciona con equipos de medición especializados y apoya a los inspectores sobre el terreno.
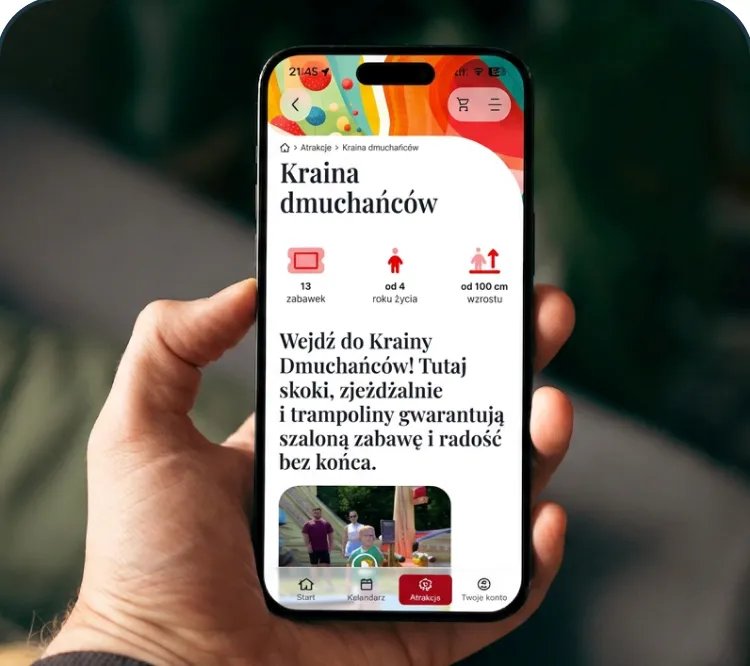 App móvil para el Parque de Atracciones JulinekJulinek es un parque de atracciones con una marca consolidada y una oferta muy variada. Nuestra tarea era diseñar y desarrollar una app móvil que permitiera a los visitantes planificar sus visitas, comprar entradas y aprovechar el parque con comodidad.
Vea cómo trabajamos con empresas de todos los tamaños
Startup
¿Tiene la idea de un nuevo producto? Desarrollamos un MVP estable sobre una arquitectura sólida, preparado para crecer y escalar sin fricciones.Pyme
¿Busca un socio tecnológico previsible? Desarrollamos y escalamos sistemas avanzados, respetando su presupuesto y cumpliendo plenamente las normas en cada etapa.Enterprise
¿Gestiona un sistema empresarial complejo? Desarrollamos y mantenemos soluciones críticas para el negocio con exigentes requisitos de seguridad y cumplimiento normativo.





- Braster
- IVES System
- Julinek
- Zign Innovation
- Genexo
- Wirelessvalue
- Blesu
- Ludify
- Big Sur Analytics
- SmartMedics
- Angelini Pharma
- SoDA
¿Se enfrenta a un problema que nadie ha resuelto antes?
Cuéntenos qué problema quiere resolver. Empezaremos por las mayores incógnitas y planificaremos una prueba de viabilidad que le ayude a decidir sobre las siguientes inversiones.
Preguntas frecuentes
Hemos reunido las preguntas más habituales para ayudarle a entender mejor nuestros servicios y procesos.
¿Cómo verifican si un problema técnico difícil tiene solución?
Empezamos por nombrar el mayor riesgo, el supuesto que invalidaría todo el proyecto si resultara falso. Después construimos una Proof of Concept con una muestra de datos reales, no sintéticos. La PoC tiene una sola misión: resolver esa pregunta concreta en un plazo y con un presupuesto fijados. El resultado es una respuesta, aunque sea «esta arquitectura no puede hacerlo». Esa respuesta al cabo de seis semanas es mucho más barata que la misma respuesta tras un año de implantación.
¿Cuánto dura una Proof of Concept y cuánto cuesta?
De una a cuatro semanas, con un presupuesto de 10.000 a 100.000 PLN netos. El lugar que ocupa un proyecto concreto dentro de este rango depende de tres cosas: el acceso a los datos, el número de integraciones que la prueba tiene que abarcar para ser significativa y cuántas personas tienen que trabajar en paralelo. Probar un supuesto con datos que usted ya tiene se sitúa cerca del extremo inferior. Una verificación que implica sistemas de producción y hardware llega al extremo superior. Cerramos el alcance en una sesión breve que termina con una sola frase: qué debe demostrar o refutar exactamente la PoC. Sin esa frase, una PoC se convierte en un pequeño proyecto sin final. El coste se conoce de antemano y no crece por el camino.
¿Integrarán la solución con nuestros dispositivos y sistemas OT?
Sí. Conectamos la capa de hardware, el software y las bases de datos en un único entorno, teniendo en cuenta los protocolos que se usan en el lado industrial, como MQTT, Modbus u OPC UA. La arquitectura tiene en cuenta el ancho de banda de los enlaces, los límites de los dispositivos edge y el hecho de que la red OT suele estar, y debe seguir estando, separada de la red de oficina. Por eso diseñamos puntos de contacto controlados en lugar de abrir el tráfico entre segmentos.
¿Se mantendrá estable el sistema sobre el terreno sin cobertura de red?
Sí, con una arquitectura offline-first. En nuestra cartera hay aplicaciones que almacenan las operaciones localmente en el dispositivo y se sincronizan en segundo plano cuando vuelve la conexión. Lo difícil no es almacenar datos sin conexión, sino resolver los conflictos: qué ocurre cuando dos personas han modificado el mismo registro mientras estaban sin cobertura. Acordamos la regla de resolución con el cliente en la fase de diseño, porque es una decisión de negocio, no técnica. Así, las operaciones funcionan con independencia de la calidad de la cobertura.
¿Se llevará una PoC exitosa a escala de producción?
Sí, y lo planificamos desde el principio. Tratamos el código de la PoC como una prueba, no como la base de la producción, por lo que reescribimos parte de él de forma deliberada. Lo que trasladamos es lo más importante: la arquitectura confirmada, los parámetros de rendimiento verificados y el conocimiento de dónde están los cuellos de botella. Después viene la capa de integración con más dispositivos y sistemas ERP, y una implantación por etapas que no detiene las operaciones.
¿Nos afectan las obligaciones de la Directiva NIS2?
Depende de su sector y de su tamaño, pero si le afectan, se traducen directamente en requisitos para el software. Añaden la gestión de riesgos de la cadena de suministro, el registro de eventos, el control de acceso, un plan de continuidad de negocio y obligaciones de notificación con plazos cortos. En la práctica, esto significa funcionalidades concretas del sistema: un registro de auditoría que no se puede modificar, la autenticación multifactor y la capacidad de restaurar el estado del sistema en el momento de un incidente. Las diseñamos desde el principio, porque añadir un registro de auditoría a un sistema terminado es uno de los cambios más caros.
¿Quién mantiene el sistema tras el lanzamiento y en qué condiciones?
El mantenimiento se rige por un SLA, y ajustamos el nivel a lo crítica que sea la solución. El paquete Essential incluye soporte en días laborables, Extended una ventana de respuesta más amplia y Full una monitorización continua. En los sistemas que controlan un proceso físico, no solo importa el tiempo de respuesta, sino también un procedimiento de emergencia acordado del lado del cliente: qué hace el turno de producción antes de que tengamos tiempo de reaccionar. Lo acordamos junto con el SLA, no después del primer incidente.